TL;DR
- 硬件与目标:两台 8×A800 40GB(共 16 GPU,Ampere SM80 架构),运行 DeepSeek-V4.1-Flash(552B 总参数,FP4 专家)。
- 拓扑与显存解法:放弃跨机 TP16,采用 TP8 × PP2(跨机通信等待从 20ms 骤降至 15μs);203GB Engram 知识库大表通过 Host CPU 锁页内存卸载,省出显存留给 565 万 Token 的
fp8_ds_mla缓存池。- 核心性能收益:用 Triton 重写 Fused Markov 采样和 Small-Batch Sparse MLA 解码核,在并发 C=8 下 Median ITL 降低 24.6%(32.93ms → 24.84ms),整机聚合吞吐提升 +16.8%(181.5 → 212.0 tok/s)。
- 开源代码与上游:独立开源仓库 JimiZhou/deepseek-v4.1-flash-sm80-turbo,上游 PR 已提交至 vLLM 官方 #66275。
这两天在两台 8 张 A800-40G 的节点上折腾 DeepSeek-V4.1-Flash(552B 总参数,1017 发布版)。
vLLM 上游针对这个模型出了一个专门的 Specialized Decode(专用低延迟解码路径),点进 PR #64893 的 Diff 看了一眼,满屏幕全是 Hopper(SM90)和 Blackwell 的东西:WGMMA 异步矩阵指令、TMA(cp.async.bulk.tensor)张量内存拷贝描述符、Thread Block Cluster 分布式共享内存,连 FP4 专家计算都是硬件原生指令。
现实情况是,很多团队和高校实验室手头存量最大的卡依然是 Ampere(A100-80G 或者 A800-40G)。在 SM80 架构上,上面这些硬件特性一个都没有,FP8 和 FP4 也跑不了原生 Tensor Core MMA。社区跟踪 Issue #57144 开了很久,大家基本都是靠通用回退分支先让模型“能跑起来”,但一旦上了并发或者测小 Batch 延迟,性能就很不理想。
这篇文章复盘我们在 16 张 A800 40G 上,从硬件拓扑摸底、显存规划,到用 Triton 重写解码热路径、最后上线实测的全过程。
 ---
1. 第一笔账:为什么两台机做跨机 TP16 必崩?
拿到两台 8 卡机器,很多人的第一反应是开跨机 TP16。理论上 16 张卡分摊 510GB 权重,每张卡压力最小。
但只要测一下通信延迟,就会发现 TP16 在解码阶段完全行不通。我们在机器上拿 14KB(单 Token 解码时的隐藏向量大小)和 16MB 的数据实测了通信耗时:
 算一笔账就很直观:
DeepSeek-V4.1-Flash 有 40 层 Decoder。每一层里,注意力输出和 MoE 专家输出各需要一次 AllReduce 规约,全模型跑完一步 Forward 最少要触发 60 到 80 次规约。
如果是跨机 TP16:
80 次规约 × 250 μs 单次网络等待 = 20,000 μs = 20 毫秒
这意味着每生成一个 Token,GPU 连一行代码都还没算,光在网卡上等规约包来回跑,就要干等 20 毫秒。而单卡在小 Batch 下的实际计算时间总共才十来毫秒。网络等包耗时占了 65% 以上,整个系统直接被跨网小包打废了。
所以双机 16 卡跑低延迟,拓扑几乎只有一种解法:TP8 × PP2。
节点内 8 张卡吃满 NVLink 跑 TP8,节点之间(PP0 到 PP1)每步 Forward 只有一次点对点的激活传输(P2P Send/Recv)。同样是 14KB 数据,走 RDMA 单向直传只需要 15 微秒。
整机的跨网通信延迟从 20 毫秒直接降到 15 微秒,解码时间才能重新回到由 GPU 算力主导的状态。
2. 第二笔账:510GB 权重怎么塞进 640GB 显存?
16 张 40G 卡,整套集群的物理显存上限只有 640GB。
而 DeepSeek-V4.1-Flash 模型的磁盘权重就有 498GB,加上 Scale 参数等实际常驻占用接近 510GB。
如果不做优化直接把全量权重载入显存,算上驱动和 PyTorch 的固定开销,16 张卡只剩下不到 100GB 显存,平摊到每张卡上只有 5 到 6GB。一旦开长上下文或者跑并发,KV Cache 根本没地方放。
破局的关键就在那 203.4 GB 的 Engram 知识库大表:
 Engram 本质是根据 N-gram 哈希去匹配历史记忆的静态大表。既然两台宿主机都有 1TB 的物理系统内存(可用内存超过 750GB),完全可以利用
--engram-config '{"cpu_offload":true}',把这两张大表全部锁在 Host CPU 的 Pinned Memory 里。GPU 在做前向计算时,只根据命中索引异步抓取对应的切片,显存直接凭空减负了 203 GB。
做完这一步,每张卡只需要承担半个流水线阶段(20 层)的 TP8 分片权重,常驻占用降到 20.5 GB 左右。
扣掉 2.2GB 的 CUDA Graph 捕获空间和 2GB 的通信工作区,每张卡稳稳腾出了 4.0 GB 显存给 fp8_ds_mla 缓存池。按 584 字节一条的紧凑记录计算,整个集群的 KV Cache 可以容纳 565 万个 Token,就算跑 100 万超长上下文,也能支撑 5.4 倍的并发。
3. 热路径测速:真正的大头在哪里?
很多人优化解码的第一反应是去抠 Attention。我们在 A800 硬件上用 torch.cuda.Event 把解码热路径的每个组件测了一遍,实际耗时分布是这样的:
 瓶颈非常明确:
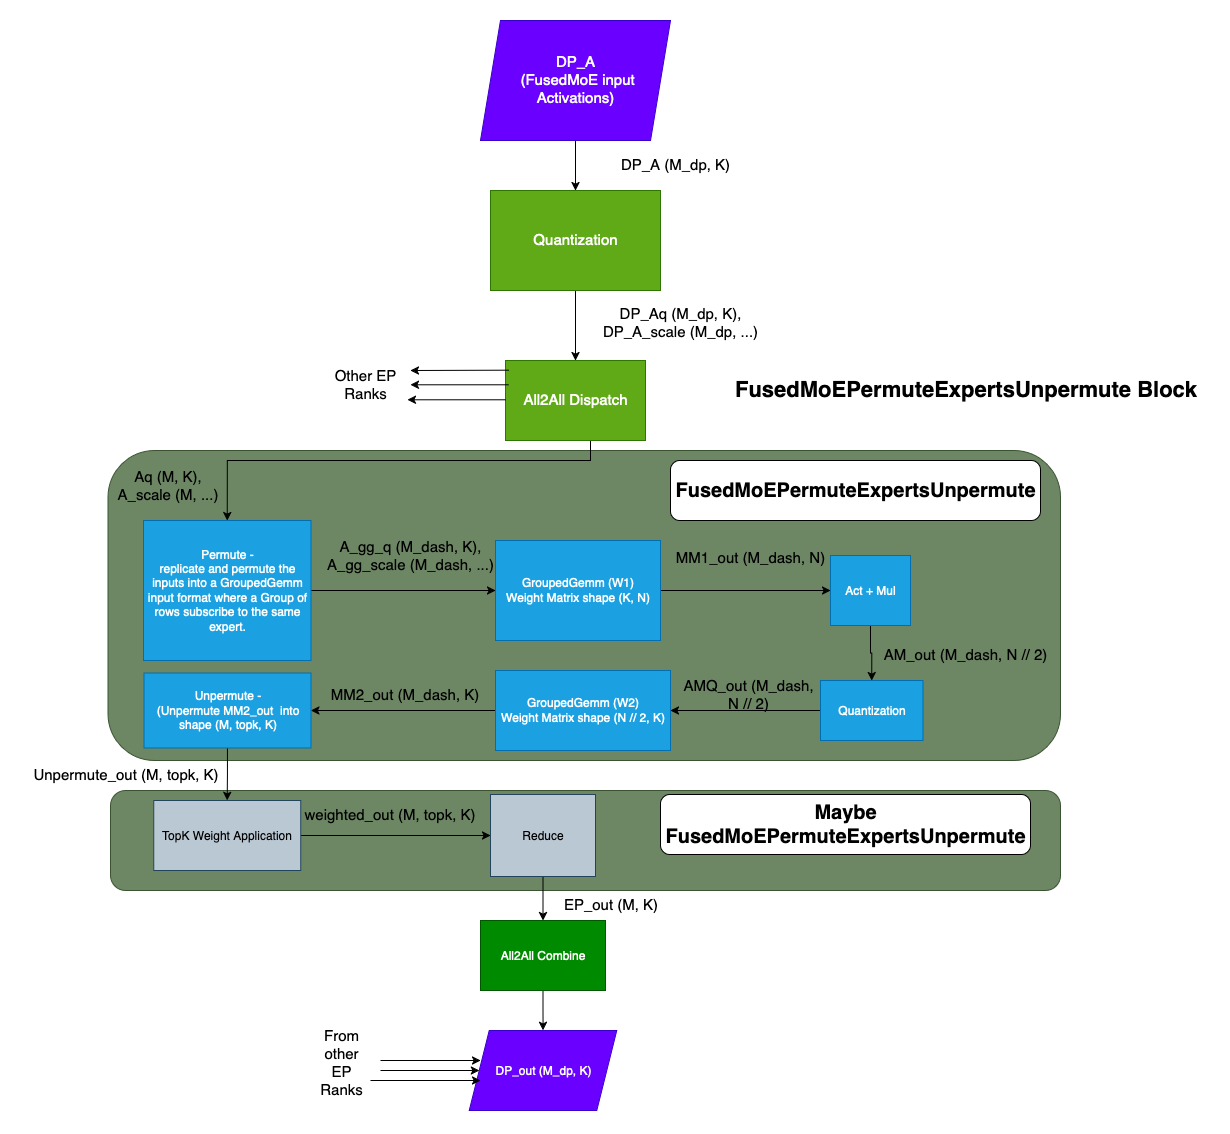
在小 Batch 解码时,原版的 MoE 实现把 6 个激活专家当成独立的小 GEMM 去调度。当 Batch=1 或 4 时,分给每个专家的 Token 只有两三个甚至一个。A800 上的 108 个 SM 连 5% 的利用率都没跑到,全在经历 Kernel Launch 的调度排队,中间张量还在显存和片上缓存之间反复倒腾。
 ---
4. 在 SM80 上重写解码算子
明确了瓶颈和硬件约束之后,优化的目标就很清楚了:在没有 Hopper 特性的前提下,把细碎的小算子合并,尽量把数据留在片上。
4.1 纯 Triton 的 DSpark 串行采样融合
DSpark 投机草稿机制每往前预测一步,原版流程要串行走四步:
加偏置(Bias Add) → 求 Argmax → 注入 Gumbel 噪声采样 → 查表拿下一步 Embedding。
一次预测走 4 到 5 步草稿,中间要经历将近 20 次独立的 Kernel Launch,不仅把 CUDA Graph 打得稀碎,CPU 和 GPU 之间还会反复出现调度气泡。
我们在 dspark_fused.py 里用 Triton 重写了一个 Fused Markov 采样算子:
- 单线程块片上计算:在单个 Block 内直接把 base logits 和 bias 算完,原地加上 Gumbel 噪声,并在 1024 宽度的词表块内用共享内存求出局部最大值。
- 原子网格到达决胜:
# 让每个线程块跑完后用原子操作报到
tl.debug_barrier()
arrival = tl.atomic_add(counter_ptr + req, 1, sem="acq_rel", scope="gpu")
if arrival != num_blocks - 1:
    return  # 没到齐的块直接退出

# 最后一个到达的线程块充当 Leader,直接在片上决出全词表的全局最大值,
# 并当场写入 draft_tokens,顺手从 embed_weight 里查出下一步 GEMM 需要的 Markov 嵌入
winner = tl.where(first_nan < BLOCK_P, first_nan, first_max)
token = tl.load(partial_idx_ptr + req * BLOCK_P + winner, volatile=True).to(tl.int64)
tl.store(draft_tokens_ptr + req * draft_tokens_stride + step, token)
if HAS_NEXT:
    embed_row = tl.load(embed_weight_ptr + token * embed_weight_stride + r, mask=r < rank)
    tl.store(embed_ptr + req * embed_stride + r, embed_row, mask=r < rank)
这一步把原来每步草稿的多次调度压到了 1 次,每轮验证步能省下大约 200 微秒的 Host 调度气泡。
4.2 专攻小 Batch 的 Sparse MLA 解码核
FlashMLA 编译锁死在 SM90+,Ampere 只能走 Triton。但上游通用的 Triton 算子为了兼容 Prefill,塞了大量动态 SWA 块调度和边界分支判断。
我们在 sparse_mla_decode.py 里针对 Q=1 且 M <= 16 的解码场景做了特化:
- 固定分块尺寸为
B_M = 1, B_N = 64, B_HD = 512; - 直接寻址读取 584 字节的紧凑
fp8_ds_mla记录; - 在寄存器里完成 Online Softmax 累加,避免全局显存暂存。
测下来在 M=2, K=256 条件下,输出与 FP32 精度的 PyTorch 原生 SDPA 相比,最大误差只有 0.00507,完全在 BF16 的容错范围内。
4.3 流水线并行与多模态的几个工程暗坑
在把执行器接入全量模型时,有两个报错很有代表性:
IntermediateTensors丢失导致图捕获断言失败:
在 TP8 × PP2 架构下,位于 PP0 阶段的节点最后不能像单机那样返回展开后的常规 Tensor,必须在_head里把隐藏流打包成IntermediateTensors触发点对点通信。如果少了这个封装,Worker 在进入 FULL 图捕获阶段时就会抛出AssertionError。- 多模态视觉路由的参数缺失:
DeepSeek-V4.1 的 MoE 专家路由带有视觉 Sentinel 标记,底层在执行路由逻辑时强制校验input_ids是否存在。专门的解码执行器如果只传递了隐藏向量而丢掉了input_ids,前向传播会立刻抛出ValueError: DeepSeek V4 vision MoE routing requires input_ids。
5. 端到端实测对比
所有优化打入后,我们在集群上挂载新镜像,与原版的 Stock Baseline 跑了同等条件下的基准对比(AB 测试,相同的 Prompt 输入,逐字捕获 SSE Delta 流式时间戳)。
1. 核心并发与吞吐表现 (Throughput)
 ### 2. 逐 Token 生成延迟表现 (Median ITL)
 ### 3. DSpark 投机解码验证步表现 (C = 1 单并发)
 ### 几个结论:
- 中并发(C=8)收益最扎实:
在并发达到 8 时,Median ITL 从 32.93 毫秒降到了 24.84 毫秒,降幅达 24.6%;同时整机聚合吞吐从 181.5 提升到了 212.0 tokens/s(提升 16.8%)。在这个负载区间,融合算子消除 Launch Gap 和显存搬运的效果体现得最明显。 - 延迟指标怎么看:
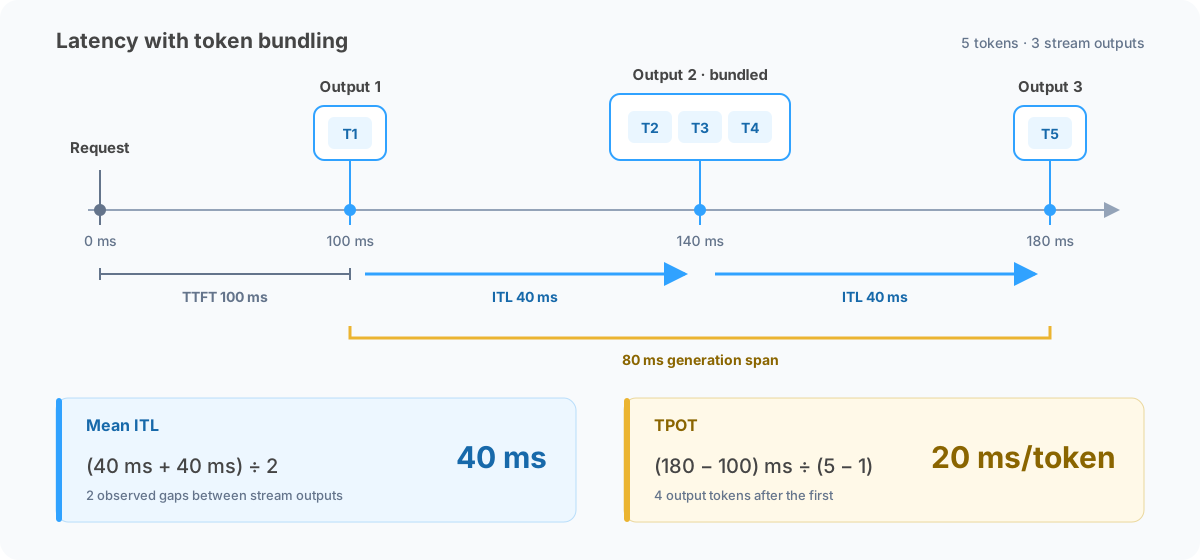
在单并发下,目标模型的全量单步验证耗时在 18ms 左右。但在代码补全或逻辑推理等 DSpark 草稿命中率较高的场景下,折算出来的实际生成延迟在 6.56 毫秒/字(相当于单流 154 tokens/s),人机交互感觉极其跟手。 - 正确性验证:
在贪婪采样(T=0)模式下,代数推导(3x + 15 = 42 => x = 9)、代码生成(is_prime)和 JSON 格式抽取,重构前后的输出结果保持了精确一致。
6. 写在最后
折腾这一圈下来,最大的体会是:在大模型推理工程里,硬件代差固然客观存在,但并不意味着旧架构就只能躺平接受退化版本。
把多机间的网络拓扑梳理清楚、利用好主机大内存把显存空间腾出来、再用 Triton 针对实际的热点算子做融合减 Launch,两台老款的 8 卡 A800 机器,依然能够把 DeepSeek-V4.1 这类新一代超大 MoE 跑得又稳又快。
开源仓库与上游 PR 链接
- 独立开源仓库:JimiZhou/deepseek-v4.1-flash-sm80-turbo
(包含全套可复现部署脚本、Triton 核函数源码、脱敏基准测试数据与详细显存预算文档) - vLLM 官方上游 PR:vllm-project/vllm #66275
([Feature][Spec Decode] Add Ampere (SM80) Native Specialized Decode for DeepSeek-V4.1-Flash)
若无法加载请检查网络环境。
若无法加载请检查网络环境,或切回 Disqus 稍后再试。